שימוש מאובטח ב API מאפליקציית מובייל הוא נושא ידוע וכאוב. סטאראט-אפים שמתחילים את דרכם רוצים רק להתקדם במוצר, ואבטחה היא לא נושא שמתעכבים עליו.
את נושא האבטחה של ה API מייחסים פעמים רבות לצד-השרת, ולכן זה "משהו שמפתחי השרת צריכים לפתור".
אנחנו ניגשים לאנשי השרת - וגם הם לא ממש בטוחים מה לעשות:
הנה מדריך יפה שמצאתי בגוגל, "The Ultimate Guide Of Mobile Security" של חברת StormPath (לארונה נרכשה ע"י OKTA).
בטוח שיש בחברה הזו מומחי אבטחה גדולים ממני. אין ספק!
מצד שני... זה המדריך האולטימטיבי? האם הוא באמת משרת את צורכי האבטחה של הקורא, או בעיקר עושה On-Boarding מהיר ספציפית לפתרון של StormPath?
גם כשאתם ניגשים למדריך מוכן, כדאי שיהיה קצת מושג - ועל כן הפוסט הבא.
אדבר על אימות שרת-לשרת, מובייל ועל אפליקציה שרצה בדפדפן, על Basic Authentication אבל גם על OAuth 2.0 וקצת על OpenID Connect.
נתחיל במקרה הפשוט ביותר (מבחינת האבטחה): תקשורת שרת-לשרת.
שיטת אימות הזהות (Authentication) הבסיסית ביותר בווב נקראת "Basic Authentication".
נניח שיש לנו תסריט בו סוכן-נסיעות (להלן "שוקה") רוצה לתקשר בצורה מאבטחת עם חברת תעופה מסוימת (להלן "שחקים").
הנה אופן הפעולה:
1. המתכנת של שחקים מייצר מפתח-זיהוי ייחודי וקשה מאוד לניחוש, שיזהה את הלקוח הספציפי - שוקה:
2. מפתח-הזיהוי אמור להישלח בצורה מאובטחת (מייל מוצפן כאשר הסיסמה מועברת בשיחת טלפון?) ללקוח, והוא אמור לשמור אותו במקום מאובטח (תיקיה עם הרשאות מוגבלות על השרת?).
3. כאשר השרת של שוקה פונה לשרת של שחקים, על גבי HTTPS, הוא מוסיף על הבקשות את ה header הבא:
הפרמטר השני הוא ה credentials ("אישור ההרשאות"), במקרה הזה: מפתח הזיהוי מקודד ב Base64.
Base64 הוא קידוד של binary-to-text הנדרש על מנת להעביר את המידע על פרוטוקול HTTP בצורה תקינה. הפרוטוקול מצפה לטקסט, ותווים מסוימים יכולים להתפרש אחרת לחלוטין (למשל: שורה ריקה משמעה שהסתיימו ה headers ומתחיל ה body של בקשת ה HTTP).
4. השרת של שחקים מזהה שמדובר ב BA, ומקודד חזרה מ Base64 את מפתח-הזיהוי. הוא משווה אותו לערך שנשמר אצלו (בצורה מאובטחת). יש התאמה? הזהות אומתה - ואכן ניתן להניח בביטחון גבוה שהבקשה הגיעה משוקה.
חוזקות:
סה״כ, עבור תקשורת שרת-לשרת, בסביבה שאיננה מרובת איומים - ה BA הוא סביר.
נקודת מפתח היא הקושי ליירט תקשורת שרת לשרת (בהנחה שהשרת לא יושב במקום ציבורי ומשתמש ב Wifi / תא סלולארי)
גרסאת ה Web Client
כאשר התקשורת היא בין דפדפן לשרת, ה flow עובד מעט אחרת:
קישורים רלוונטיים
ה OAuth 2.0 Threat Model המגדיר את הסיכונים השונים ביישום OAuth.
ה OAuth Grants מוסברים על ידי Alex Bilbie.
עוד קישור טוב על OAuth 2.0
"OAuth has ruined everything"
מדריך טוב ל OpenID Connect
את נושא האבטחה של ה API מייחסים פעמים רבות לצד-השרת, ולכן זה "משהו שמפתחי השרת צריכים לפתור".
אנחנו ניגשים לאנשי השרת - וגם הם לא ממש בטוחים מה לעשות:
- האם יש משהו לא טוב ב Basic Authentication? הרי "Basic is beautiful" (ע"פ פוקס).
- אולי עדיף להוסיף כל מיני "טריקים שמקשים"? אולי לחפש ב StackOverflow?
הנה מדריך יפה שמצאתי בגוגל, "The Ultimate Guide Of Mobile Security" של חברת StormPath (לארונה נרכשה ע"י OKTA).
בטוח שיש בחברה הזו מומחי אבטחה גדולים ממני. אין ספק!
מצד שני... זה המדריך האולטימטיבי? האם הוא באמת משרת את צורכי האבטחה של הקורא, או בעיקר עושה On-Boarding מהיר ספציפית לפתרון של StormPath?
גם כשאתם ניגשים למדריך מוכן, כדאי שיהיה קצת מושג - ועל כן הפוסט הבא.
אדבר על אימות שרת-לשרת, מובייל ועל אפליקציה שרצה בדפדפן, על Basic Authentication אבל גם על OAuth 2.0 וקצת על OpenID Connect.
נתחיל מההתחלה: Basic Authentication (בקיצור: BA)
נתחיל במקרה הפשוט ביותר (מבחינת האבטחה): תקשורת שרת-לשרת.
נניח שיש לנו תסריט בו סוכן-נסיעות (להלן "שוקה") רוצה לתקשר בצורה מאבטחת עם חברת תעופה מסוימת (להלן "שחקים").
הנה אופן הפעולה:
1. המתכנת של שחקים מייצר מפתח-זיהוי ייחודי וקשה מאוד לניחוש, שיזהה את הלקוח הספציפי - שוקה:
jsa7arpZ8sPZ60YZyZwfD97gf5cHbEBj77VF6nF4מחרוזת אקראית באורך 40 תווים נחשבת כיום למפתח מספיק חזק.
2. מפתח-הזיהוי אמור להישלח בצורה מאובטחת (מייל מוצפן כאשר הסיסמה מועברת בשיחת טלפון?) ללקוח, והוא אמור לשמור אותו במקום מאובטח (תיקיה עם הרשאות מוגבלות על השרת?).
3. כאשר השרת של שוקה פונה לשרת של שחקים, על גבי HTTPS, הוא מוסיף על הבקשות את ה header הבא:
Authorization: Basic anNhN2FycFo4c1BaNjBZWnlad2ZEOTdnZjVjSGJFQmo3N1ZGNm5GNA==הפרמטר הראשון אומר איזו סוג זיהוי (Authentication) מדובר. במקרה הזה: BA.
הפרמטר השני הוא ה credentials ("אישור ההרשאות"), במקרה הזה: מפתח הזיהוי מקודד ב Base64.
Base64 הוא קידוד של binary-to-text הנדרש על מנת להעביר את המידע על פרוטוקול HTTP בצורה תקינה. הפרוטוקול מצפה לטקסט, ותווים מסוימים יכולים להתפרש אחרת לחלוטין (למשל: שורה ריקה משמעה שהסתיימו ה headers ומתחיל ה body של בקשת ה HTTP).
4. השרת של שחקים מזהה שמדובר ב BA, ומקודד חזרה מ Base64 את מפתח-הזיהוי. הוא משווה אותו לערך שנשמר אצלו (בצורה מאובטחת). יש התאמה? הזהות אומתה - ואכן ניתן להניח בביטחון גבוה שהבקשה הגיעה משוקה.
חוזקות:
- פרוטוקול פשוט שקל ליישום.
חולשות:
- מפתח-הזיהוי מועבר על כל בקשה, ועל כן תוקף פוטנציאלי יכול לנסות ולקרוא אותו. מי שיש לו את המפתח - יכול להזדהות בשם הלקוח (״שוקה״).
סה״כ, עבור תקשורת שרת-לשרת, בסביבה שאיננה מרובת איומים - ה BA הוא סביר.
נקודת מפתח היא הקושי ליירט תקשורת שרת לשרת (בהנחה שהשרת לא יושב במקום ציבורי ומשתמש ב Wifi / תא סלולארי)
גרסאת ה Web Client
כאשר התקשורת היא בין דפדפן לשרת, ה flow עובד מעט אחרת:
- אין תקשורת מוקדמת עם המשתמש, ולא שלוחים לו מפתח-זיהוי.
- המשתמש פונה ל URL הרצוי.
- השרת שאינו מזהה את המשתמש, מחזיר HTTP Status 401, כלומר: Unauthorized - "אני לא יודע מי אתה". כמו כן הוא שולח header המסביר באיזו סוג authentication הוא תומך:
WWW-Authenticate: Basic
- הדפדפן יקפיץ למשתמש חלון להקלדת שם-משתמש וסיסמה.
- הדפדפן ייצור מחרוזת credentials כ ״שם משתמש:סיסמה״ - יקודד אותה ב Base64 ויעביר אותה על ה Authorization Header בקריאה הבאה:
Authorization: Basic <credentials>
- השרת יפתח את הקידוד ויזהה אם יש לו משתמש עם סיסמה שכזו. אם כן - הוא יניח שהבקשה הגיעה מהמשתמש.
- שם המשתמש והסיסמה ישארו ב cache של הדפדפן לזמן מוגדר (15 דקות?). בכל בקשה לשרת יישלח ה Authorization Header עם הסיסמה.
חוזקות:
- פרוטוקול פשוט שקל ליישום.
חולשות:
- שם המשתמש והסיסמה עוברים כ clear text על כל בקשה (Base64 שקול ל clear text). תקשורת בין endpoint (לצורך פוסט זה: ״תחנת קצה״ -כמו מחשבים ניידים או סמארטפונים) לשרת - הרבה יותר קל ליירט מאשר תקשורת שרת לשרת. למשל: התוקף ותחנת הקצה נמצאים על אותה רשת Wifi.
- אם התקשורת נעשית על גבי HTTP (רחמנא ליצלן!) - אזי גניבת הסיסמה היא פעולת sniffing פשוטה.
- שם המשתמש והסיסמה נשארים cached בדפדפן. תוקף יכול לעשות שימוש גם הוא ב credentials מבלי שאף אחד יידע (התקפת CSRF).
סה״כ, BA בדפדפן היא שיטה שנחשבת כחלשה למדי לזיהוי מאובטח של המשתמש, והיא איננה מומלצת לשימוש.
גרסאת המובייל
במובייל יש כמה אפשרויות:
ל HTTP יש עוד שיטת Authentication שנקראת HTTP Digest Access Authentication, שמנסה להקשות על גילוי הסיסמה - אך בפועל כיום היא נחשבת שיטה פחות בטוחה מ BA.
המחשבה ש"אני משתמש ב OAuth 2.0 - ולכן אני מאובטח", היא אולי נעימה - אך לא ממש נכונה. ל OAuth 2.0 יש יתרונות - אך גם חסרונות.
ראשית כל OAuth 2.0 הוא פרוטוקול ל Delegated Access ("ייפוי כח") ולא ל Authentication ("אימות זהות). הפרוטוקול נבנה על מנת לאפשר "ייפוי כח" למישהו אחר לגשת למידע שבבעלותי אך נשמר על ידי צד שלישי. בתוך ה Protocol מוגדרת "מסגרת ל Authentication" שהיא כללית, ואיננה נחשבת כחזקה במיוחד.
מעט היסטוריה שתעזור להבין את השתלשלות האירועים:
לא נכון להשוות בין OpenID ל OpenID Connect. זה כמו להשוות בין Ext2 ללינוקס (בהגזמה).
OIDC אינו תואם ל OpenID בגרסאותיו השונות - הוא רק שואב מהם רעיונות.

הנה ה Flow הבסיסי של OIDC, שהוא בעצם התאמה של ה Flow המקביל שתואר עבור OAuth 2.0:
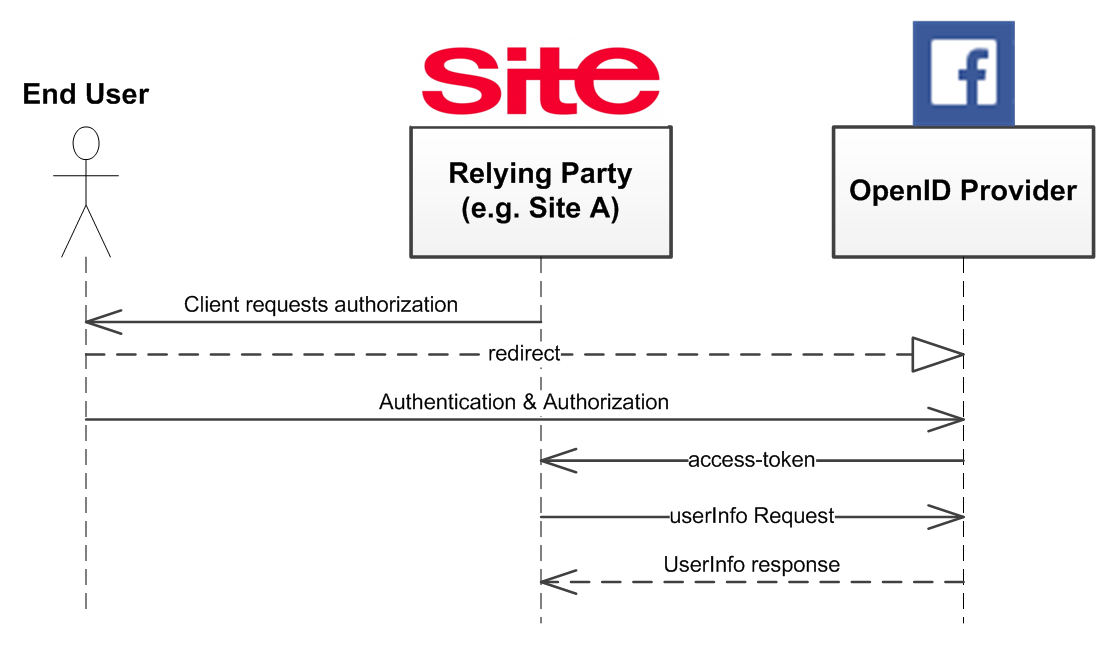
 ה Flow מעט פשוט יותר, לא מתבסס בהכרח על דפדפן, והיעד הוא להשיג מידע על המשתמש - ולא "משאב כללי".
OpenID מסומן היום כמחליף הטבעי של SAML 2.0 (פרוטוקול אימות זהות / SSO) מסורבל ועם תיעוד לקוי - אבל שמילא את מטרתו במשך תקופה נכבדת.
אם אתם רוצים גישה למשאב (ולא זהות) - OAuth 2.0 הוא עדיין רלוונטי (אם כי אתם יכולים לתפור הרחבה תקנית על גבי OIDC ולהימנע מסכנות רבות).
בתחום המובייל (כלומר: native app) פרוטוקול ה OIDC עדיין לא נחשב טוב מספיק. שתי תקנים מרכזיים Proof Of Possession ו PKCE בפיתוח - ואמורים להעלות מדרגה בתחום.
OpenID Connect הוא לא מושלם. למשל: קיימת עדיין הדילמה של החזקת גישה למערכות רבות ע"י Identity Provider אחד. יש סכנה שפריצה למערכת הזו תאפשר גישה לתוכן רב - אך היא ככל הנראה פחותה מהסכנה שבפיזור ססמאות. מבין האופציות הקיימות, OpenID Connect היא האופציה העדיפה.
טוב, יכול להיות שפוסט זה הוא לא חומר הקריאה האידאלי בחופשת החג - עם הילדים. יכול להיות...
מצד שני, אם אתם הולכים לבצע תהליך Authentication בווב - כדאי שתכירו את מגוון האפשרויות הקיים והשמעות שלהן. אני לא טוען שיש לממש במערכת "מקסימום אבטחה", הכל תלוי בהקשר. כנראה שהכי נכון זה לממש "מספיק אבטחה". כמה זה "מספיק"? - רק אתם תוכלו לומר.
שיהיה בהצלחה!
----במובייל יש כמה אפשרויות:
- אפשר לנסות ולהיצמד לגרסת השרת של ה BA: ולשלוח מפתח-זיהוי לכל משתמש - אך זה אפשרי רק עם התקנה ידנית של Certificate (תהליך סזיפי למשתמש) או מערכות ששותלות Agent במכשיר ועושות זאת - בעיקרון מערכות Enterprise שלא ישימות בסביבת Consumers.
- אפשר לנסות ולהיצמד לגרסת הדפדפן של ה BA: ולשמור את שם המשתמש והסיסמה באחסון המוגן של המכשיר (shared preferences / key chain) - ואז לשלוח אותם כ credentials בכל בקשה.
שליחת ה credentials, בכל בקשה, ובמיוחד מתוך endpoints היא חולשה משמעותית - ולכן לא ניתן להמליץ על הגישה הזו.
ל HTTP יש עוד שיטת Authentication שנקראת HTTP Digest Access Authentication, שמנסה להקשות על גילוי הסיסמה - אך בפועל כיום היא נחשבת שיטה פחות בטוחה מ BA.
הבו לנו OAuth 2.0!
רוב הסיכויים שאתם שמעתם על פרוטוקול 2.0 OAuth ל Authentication. יש לו שם של פרוטוקול מכובד "Enterprise Level", אולי הנפוץ ביותר לשימוש היום - ולכן אפשר לסמוך עליו!
המחשבה ש"אני משתמש ב OAuth 2.0 - ולכן אני מאובטח", היא אולי נעימה - אך לא ממש נכונה. ל OAuth 2.0 יש יתרונות - אך גם חסרונות.
ראשית כל OAuth 2.0 הוא פרוטוקול ל Delegated Access ("ייפוי כח") ולא ל Authentication ("אימות זהות). הפרוטוקול נבנה על מנת לאפשר "ייפוי כח" למישהו אחר לגשת למידע שבבעלותי אך נשמר על ידי צד שלישי. בתוך ה Protocol מוגדרת "מסגרת ל Authentication" שהיא כללית, ואיננה נחשבת כחזקה במיוחד.
החלק הזה "מפיל" אנשים, ולכן אני הולך לתת חיזוק לטענה:
 |
| מתוך האתר הרשמי של OAuth, קישור: https://oauth.net/articles/authentication |
והנה הגדרה פורמאלית מה OAuth כן עושה:
שימו לב לקשר החזק ל HTTP.
מכיוון Authentication ב OAuth היא רק Framework ולא פרוטוקול - אין הגדרה חד-משמעית ומדויקת כיצד ה Authentication אמורה להתבצע. זה אומר ש:
כיצד OAuth 2.0 עובד (בקצרה)
OAuth בעצם מגדיר ארבע אופנים שונים (נקראים Grants) לקבל Token ולהשתמש בו.
ה Token הוא תחליף ל Password, מכיוון שיצירת password במערכות רבות היא סכנת אבטחה ממשית: אנשים נוטים לעשות שימוש חוזר ב passwords שלהם במערכות שונות, ומערכת אחת שנפרצת - מאפשרת גישה למערכות נוספות, לעתים חשובות יותר.
Authorization code grant
זהו כנראה אופן השימוש הנפוץ ביותר ב OAuth. אתחיל בלתאר אותו בצורה "סיפורית":
עכשיו המשתמש רוצה להתחבר לשירות A (למשל: ל Comeet), שם מופיעה לו אופציה להתחבר בעזרת החשבון הקיים שלו בשירות B, למשל: "Connect with Linkedin".

המשתמש מקיש על הלינק של "חיבור בעזרת...", וקופצת חלונית חדשה בדפדפן (יש הנחה שמדובר בדפדפן) בה מתבצע תהליך ה Authentication מול ה Auth. Server, שהוא לרוב בעצם שירות B עצמו (למשל: לינק-אין).
שירות B מציג אלו פריטי מידע (resource) הוא התבקש לחשוף (לעתים זהו רק ה email, לעתים רשימת חברים ויותר) וכאשר המשתמש מאשר - הוא חוזר לאתר המקורי (שירות A) ומקבל אליו גישה.
התוצאה: המשתמש קיבל גישה לשירות A מבלי שהיה צריך להזין בו שם משתמש / סיסמה. לעתים חושבים שלא נוצר שם חשבון - אך לרוב הוא נוצר על בסיס מזהה ייחודי שסיפק שירות B.
עכשיו נחזור על ה flow בצורה יותר טכנית:
לפני שהכל מתחיל, ה Client (למשל "Site") נרשם אצל Resource Server (למשל: Facebook). כתוצאה מתהליך הרישום ה Client מקבל client_secret ("מפתח זיהוי") - אותו הוא שומר בצורה מאובטחת.

כעת המשתמש רוצה להתחבר לשירות A:
העיקרון מאחורי ה tokens נקרא TOFU (קיצור של Trust On First Use), והוא אומר שבמקום לשלוח את מפתח הזיהוי בכל בקשה - תוך כדי שאנחנו חשופים ל sniffing, נצמצם את החשיפה לתקשורת הראשונה. בפעולה הראשונה אנו סומכים (יותר) על הצד השני, תחת ההנחה שפחות סביר להיות חשופים ל sniffing ברגע ההתקשרות הראשונית. אם ה access token, למשל, נחשף ב sniffing - הפגיעה תהיה מוגבלת לזמן הנתון, ועדיין ה refresh token וה client_secret לא נחשפו והם יכולים להמשיך לנפק בצורה מאובטחת יחסית access_tokens אחרים.
ציינו שיש 4 סוגים שונים של Grant בתקן. הנה תרשים החלטה מקובל שעוזר להחליט באיזה Grant כדאי להשתמש (מבוסס על תרשים של Alex Bilbie):

בקצרה:
באיזה Flow כדאי להשתמש באפליקציית מובייל?
ב Spec המקורי ההגדרה הייתה להשתמש ב Implicit Grant: מעט אמון, ומעט אבטחה.
מאז יש מעבר לשימוש ב Authorization Code Grant, כאשר משתמשים להרשאות ב Native Browser ולא WebView. למשל: SFSafariViewController ולא WKWebView.
האם אפליקציית מובייל יכולה לשמור Client Secret ב Source Code שלה בצורה אמינה? באנדרואיד, למשל, קל מאוד להוריד apk ולבצע לו Reverse Engineering. ההמלצה אם כן היא להחזיק את הקוד ויישום ה OAuth בקוד ++C (קרי שימוש ב NDK) ולא ב Java - שם ה reverse engineering הוא קשה משמעותית.
Stormpath (שנרכשו לאחרונה ע"י OKTA) בכלל לא דנים בשאלה - ושולחים את המתכנתים ליישם Password Grant. אני לא בטוח שלא מעורבים פה שיקולים עסקיים (לספק Flow שקל ללקוחות ליישם, ולא להטריד אותם ב"זוטות").
התשובה המורכבת יותר היא: זה תלוי ב Use-case: כמה האפליקציה שלכם נפרצת? כמה רגישים הנתונים שאתם ניגשים אליהם בעזרת האפליקציה? רמת האבטחה כאן היא, במידה רבה, בפרטים.
לסיכום:
בתקשורת שרת לשרת
בתקשורת Web
בתקשורת מובייל
The OAuth 2.0 authorization framework enables a third-party application to obtain limited
access to an HTTP service, either on behalf of a resource owner by orchestrating an
approval interaction between the resource owner and the HTTP service, or by allowing the
third-party application to obtain access on its own behalf.
שימו לב לקשר החזק ל HTTP.
מכיוון Authentication ב OAuth היא רק Framework ולא פרוטוקול - אין הגדרה חד-משמעית ומדויקת כיצד ה Authentication אמורה להתבצע. זה אומר ש:
- ה Framework משאיר נושאים מסוימים לבחירת המימוש: איך להשתמש ב scopes, איך לבצע endpoint discovery, רישום דינאמי של לקוחות, וכו'.
- אין בהכרח תאימות בין מימוש א' למימוש ב'. אם גוגל ופייסבוק מאפשרים חיבור ב OAuth - לא בטוח שאותו מימוש (של Client) יוכל לעבוד מול שניהם.
- יש מימושים מאובטחים יותר, ומימושים מאובטחים פחות. תו התקן "OAuth" מציין בעיקר את סדר ההתקשרות - אבל מבטיח אבטחה רק במידה מסוימת.
- למשל: לא נאמר כיצד להעביר את מפתח ההזדהות. ב URL או כ Header? (עדיף Header כי פחות סביר שהמידע הרגיש הזה יצוץ אח"כ בלוגים)
- כיצד להעביר את המידע בין השחקנים השונים? לכאורה עדיף להצפין את נתוני ה token, אך יש כאלו שמשאירים אותם גלויים כי נוח שה Client יכול לקרוא גם הוא נתונים על המשתמש....
- הנה רשימת עשרת החולשות הנפוצות ביותר במימושים של OAuth 2.0.
כיצד OAuth 2.0 עובד (בקצרה)
OAuth בעצם מגדיר ארבע אופנים שונים (נקראים Grants) לקבל Token ולהשתמש בו.
ה Token הוא תחליף ל Password, מכיוון שיצירת password במערכות רבות היא סכנת אבטחה ממשית: אנשים נוטים לעשות שימוש חוזר ב passwords שלהם במערכות שונות, ומערכת אחת שנפרצת - מאפשרת גישה למערכות נוספות, לעתים חשובות יותר.
כדי להבין את OAuth כדאי להשקיע דקה ולהכיר את ה"שחקנים" (Roles) המדוברים:
Resource Owner
Resource Owner
זה בעצם המשתמש, וכך גם אקרא לו בפוסט.
Resource Server (נקרא גם בשם המבלבל "protected resource")
אקרא לו בפוסט גם "שירות B" - השרת שמאכסן את הנתונים של המשתמש, למשל פייסבוק.
Authentication Server
השרת שמולו המשתמש מזדהה, כלומר שם מתבצע תהליך ה Authentication והוא מנפיק Token שמאמת את זהות המשתמש. ברוב המקרים זהו יהיה ה Resource Server עצמו (או שירות B) - אך התקן לא מחייב זאת.
Client
אקרא לו בפוסט גם בשם "שירות A" - השירות שאליו בעצם פונה המשתמש בבקשה לשירות.
שירות זה לקוח של ה Resource Server והוא מבקש ממנו גישה למשאבים השייכים למשתמש, להלן "ייפוי הכח".
שירות זה לקוח של ה Resource Server והוא מבקש ממנו גישה למשאבים השייכים למשתמש, להלן "ייפוי הכח".
Authorization code grant
זהו כנראה אופן השימוש הנפוץ ביותר ב OAuth. אתחיל בלתאר אותו בצורה "סיפורית":
עכשיו המשתמש רוצה להתחבר לשירות A (למשל: ל Comeet), שם מופיעה לו אופציה להתחבר בעזרת החשבון הקיים שלו בשירות B, למשל: "Connect with Linkedin".

המשתמש מקיש על הלינק של "חיבור בעזרת...", וקופצת חלונית חדשה בדפדפן (יש הנחה שמדובר בדפדפן) בה מתבצע תהליך ה Authentication מול ה Auth. Server, שהוא לרוב בעצם שירות B עצמו (למשל: לינק-אין).
שירות B מציג אלו פריטי מידע (resource) הוא התבקש לחשוף (לעתים זהו רק ה email, לעתים רשימת חברים ויותר) וכאשר המשתמש מאשר - הוא חוזר לאתר המקורי (שירות A) ומקבל אליו גישה.
התוצאה: המשתמש קיבל גישה לשירות A מבלי שהיה צריך להזין בו שם משתמש / סיסמה. לעתים חושבים שלא נוצר שם חשבון - אך לרוב הוא נוצר על בסיס מזהה ייחודי שסיפק שירות B.
עכשיו נחזור על ה flow בצורה יותר טכנית:
לפני שהכל מתחיל, ה Client (למשל "Site") נרשם אצל Resource Server (למשל: Facebook). כתוצאה מתהליך הרישום ה Client מקבל client_secret ("מפתח זיהוי") - אותו הוא שומר בצורה מאובטחת.

- שירות A מבקש מהמשתמש להזדהות, ומאפשר לו לעשות את זה בעזרת שירות B.
- המשתמש בוחר בשירות B, ומופנה ל Authentication Server המתאים.
- שירות A סומך על ה Authentication Server לבצע אימות מאובטח מספיק, ולנפק access-token מתאים.
- בד"כ מוצג למשתמש אילו נתונים הוא הולך למסור, ולעתים הוא יכול להחליט לא למסור חלק מהנתונים. כל קבוצת נתונים מוגדרת כ scope. על ה redirect URL ה Client ציין אלו scopes הוא מבקש.
- המשתמש מזדהה בעזרת שם משתמש וסיסמה (או כל אימות אחר) ומאשר את ה scopes.
- ישנו Redirect חזרה ל Client עליו מופיעים פרטים של הבקשה המקורית ל Authentication - שבהם ישתמש ה Client על מנת לאמת שזו אכן תשובה לבקשה שנשלחה, authorization code.
- ה Client עכשיו פונה ל Auth. Server בעצמו,
- ושולח לו:
- את ה authorization code שקיבל
- client_id - זיהוי של ה client (לא של המשתמש), אינו סודי.
- client_secret - קוד סודי שרק ה client מכיר (אותו הוא קיבל ברישום).
- בתמורה הוא מקבל אובייקט JSON המכיל:
- תאריך תפוגה - ה token טוב לזמן מוגבל (באיזור השעה, בד"כ).
- access_token - איתו הוא יכול לגשת לנתונים.
- refresh_token - המאפשר לבקש גישה נוספת, במידה וה access_token פג תוקף.
- הערה: התקן של OAuth לא מציין מה מבנה ה token, אך מקובל להשתמש ב JWT (קיצור של: JSON Web Token), פורמט הכולל 3 חלקים: Claims, Header, וחתימה.
העיקרון מאחורי ה tokens נקרא TOFU (קיצור של Trust On First Use), והוא אומר שבמקום לשלוח את מפתח הזיהוי בכל בקשה - תוך כדי שאנחנו חשופים ל sniffing, נצמצם את החשיפה לתקשורת הראשונה. בפעולה הראשונה אנו סומכים (יותר) על הצד השני, תחת ההנחה שפחות סביר להיות חשופים ל sniffing ברגע ההתקשרות הראשונית. אם ה access token, למשל, נחשף ב sniffing - הפגיעה תהיה מוגבלת לזמן הנתון, ועדיין ה refresh token וה client_secret לא נחשפו והם יכולים להמשיך לנפק בצורה מאובטחת יחסית access_tokens אחרים.
- בשלב האחרון ה Client ניגש לשירות B בעזרת ה access_token - ושולף ממנו את הנתונים שביקש.
לכאורה בתרשים זו קריאה בודדת, אך בעצם יכולות להיות עוד קריאות לאורך זמן. - אם פג התוקף של ה access token, ה Client לא יורשה לקבל את הנתונים. הוא יצטרך לפנות עם ה refresh_token ל Auth. Server ולקבל access_token ו refresh_token חדשים.

בקצרה:
- Authorization Code Grant - הוא ה flow שעברנו עליו. אם המשאב הוא זיהוי של המשתמש (למשל: email), אזי יישמנו סוג של מנגנון Authentication על גבי OAuth.
- ה Flow מתבסס על המצאות דפדפן והיכולת לבצע Re-direct (כלומר: Multi-page app, לפחות לשלב ה login).
- ה Client הוא צד-השרת של האפליקציה, בו ניתן לשמור את ה client_secret בצורה מאובטחת.
- Client Credentials Grant - הוגדר עבור חלקים שונים של אותה האפליקציה (הגדרה: "ה Client עצמו הוא ה Resource Owner"), שיש בין החלקים אמון גבוה. האימות הוא שרת-לשרת, ולא דורש התערבות של המשתמש. זהו בעצם מן גרסה משופרת של Basic Authentication בין שרת לשרת שמיישם את עקרון ה TOFU. מיותר לציין שנעשה שימוש נרחב ב Flow זה גם בין אפליקציות זרות, וזה לא דבר רע בהכרח (יותר טוב מ Basic Auth).
- Flow זה גם נקרא two-legged OAuth (כי יש בו רק שני שחקנים מעורבים), בניגוד לכל שאר ה flows הנקראים three-legged OAuth.
- Implicit Grant - הוגדר עבור אפליקציות ווב או מובייל שבהן לא ניתן לסמוך ברמה גבוהה על ה client_secret. לאפליקציית mobile ניתן לעשות reverse engineering ולשלוף את הקוד, בווב - ...זה אפילו יותר קל.
- יש כאן פשרה של אבטחה על מנת לאפשר כן סוג של Delegation סביר של הרשאות.
- ב Flow הזה אין refresh Token - ולאחר שפג תוקפו של ה access_token יש לבצע Authentication מחדש.
- לא מעבירים ל Client את ה Auth. Code (כי לא סומכים עליו - הוא לא מספק אבטחה מוגברת), אלא ישר שולחים לו את ה access-token.
- Password Credentials Grant (נקרא גם Resource Owner Credentials Grant) - הוגדר עבור אפליקציות בעלות Trust גבוה. ב Flow הזה המשתמש מספק את שם המשתמש וההרשאות שלו לאפליקציה (שלא שומרת אותן!), והיא משתמשת בהן על מנת לקבל access_token בשמו. את ה access_token אפשר לשמור בצורה מאובטחת(!) באפליקציה.
- אם ה access_token נגנב אז אפשר לגשת איתו רק לנתונים מסוימים של משתמש יחיד - נזק מוגבל.
- את ה access_token יש לחדש מדי פעם, על ידי זיהוי מחדש של המשתמש. באפליקציות מובייל לא מקובל לבקש מהמשתמש סיסמה מחדש יותר מפעם בזמן מה.... חודש, נניח?
באיזה Flow כדאי להשתמש באפליקציית מובייל?
ב Spec המקורי ההגדרה הייתה להשתמש ב Implicit Grant: מעט אמון, ומעט אבטחה.
מאז יש מעבר לשימוש ב Authorization Code Grant, כאשר משתמשים להרשאות ב Native Browser ולא WebView. למשל: SFSafariViewController ולא WKWebView.
האם אפליקציית מובייל יכולה לשמור Client Secret ב Source Code שלה בצורה אמינה? באנדרואיד, למשל, קל מאוד להוריד apk ולבצע לו Reverse Engineering. ההמלצה אם כן היא להחזיק את הקוד ויישום ה OAuth בקוד ++C (קרי שימוש ב NDK) ולא ב Java - שם ה reverse engineering הוא קשה משמעותית.
Stormpath (שנרכשו לאחרונה ע"י OKTA) בכלל לא דנים בשאלה - ושולחים את המתכנתים ליישם Password Grant. אני לא בטוח שלא מעורבים פה שיקולים עסקיים (לספק Flow שקל ללקוחות ליישם, ולא להטריד אותם ב"זוטות").
התשובה המורכבת יותר היא: זה תלוי ב Use-case: כמה האפליקציה שלכם נפרצת? כמה רגישים הנתונים שאתם ניגשים אליהם בעזרת האפליקציה? רמת האבטחה כאן היא, במידה רבה, בפרטים.
לסיכום:
בתקשורת שרת לשרת
חוזקות:
- עדיין פשוט ליישום.
- TOFU עדיף על העברה של המפתח בכל פעם.
חולשות:
- לא תוכנן במקור לשימוש בין שרתים עם Trust מוגבל.
סה"כ טוב מספיק עבור מגוון שימושים, ועדיף על פני Basic Authentication.
בתקשורת Web
חוזקות:
- עדיף על Basic Authentication, בכמה מובנים (בעיקר Authorization Code Grant).
- הפך כמעט לקונצנזוס - יש מעט מאוד מתחרים, לכל אחד את הבעיות שלו.
חולשות:
- לא תוכנן כפרוטוקול Authentication.
- מימוש יחסית מורכב בצד-השרת (בצד-הלקוח המימוש טריוויאלי)
- Room For Error: ה Specification שלו מבלבל, ומגוון האפשרויות - מובילים למימושים / יישומים רבים שאינם באמת מאובטחים דיים. מספק "תחושת אבטחה מוגזמת".
בתקשורת מובייל
חוזקות:
- עדיף על Basic Authentication.
חולשות:
- Mobile App נחשבת לעתים קרובות כ Trusted - למרות שזה שיקוף לא נכון של המציאות.
- חלק ממנגנוני האבטחה של OAuth מסתמכים על המצאות דפדפן שאפשר לסמוך עליו: אין יכולת ל redirect. שימוש ב WebView פותח פתח ל Phishing / Clickjacking.
- Implicit Grant טוב מ Basic Authentication רק במעט.
OpenID Connect
מעט היסטוריה שתעזור להבין את השתלשלות האירועים:
- 2006- יצא תקן לאימות זהות בשם OpenID 1.0. הוא עובד בערך כך: "אני ליאור", שואלים צד שלישי שסומכים עליו: "האם זה ליאור?", התשובה היא "זה ליאור" - ואז מאשרים את זהותי.
- 2007 - יצא OpenID 2.0 עם כמה שיפורים.
- 2007 - יצא 1.0 OpenID Attribute Exchange (בקיצור OIDAE) - הרחבה של OpenID 2.0 המאפשרת גם למשוך פרטים נוספים על המשתמש "זה ליאור, הוא בן 40, ויש לו 3 ילדים".
- 2010 - יצא OAuth 1.0
- 2012 - יצא OAuth 2.0
- 2014 - יצא פורטוקול OpenID Connect (בקיצור: OIDC) שמשלב בין OpenID 2.0 + OIDAE על גבי ה Framework של OAuth 2.0 בצירוף של JWT (וחברים).
לא נכון להשוות בין OpenID ל OpenID Connect. זה כמו להשוות בין Ext2 ללינוקס (בהגזמה).
OIDC אינו תואם ל OpenID בגרסאותיו השונות - הוא רק שואב מהם רעיונות.
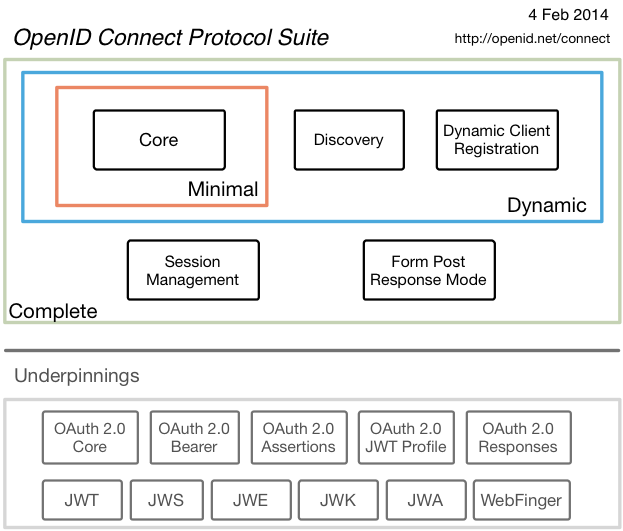
OIDC הוא פרוטוקול, והוא סוגר הרבה מהפינות הפתוחות של OAuth 2.0:
- הוא מחייב כללים רבים שהם בגדר המלצה ב OAuth 2.0.
- הוא מגדיר את מבנה ה tokens (על בסיס JWT) - שב OAuth 2.0 פתוחים לפרשנות.
- הוא מגדיר scopes סטנדרטיים (email, phone, וכו') - המאפשרים התנהגות סטנדרטית מסביב למידע בסיסי של המשתמש. הפרוטוקול מגדיר endpoint חדש הנקרא userInfo Endpoint ממנו ניתן לשאוב מידע בסיסי על המשתמש.
- הוא גם פותח בתקופה בה אפליקציות מובייל הן מאוד משמעותיות, ויש התייחסות רחבה יותר למובייל בהגדרת הפרוטוקול.
- החל מ 2015 יש הסמכה של OIDC, ויש רשימה של מימושים שהם Certified, אפשר כבר לצפות ל Compatibility.
- OIDC מגדיר סוג נוסף של token הנקרא ID Token המאפשר ל Client לדעת כמה פרטים על המשתמש ועל מצב ב Authentication שלו. עיוות נפוץ של מימושי OAuth 2.0 הוא לאפשר ל Client לקרוא את ה Access Token - מה שפוגע ב Segregation of duties.
- הפרוטוקול מוסיף הגנה בפני התקפת replay: עשיתי sniffing לתקשורת ולא הבנתי מה נאמר - אבל אבקש מהשרת לעשות זאת עוד פעם (מה שלעתים יגרום נזק).
הנה ה Flow הבסיסי של OIDC, שהוא בעצם התאמה של ה Flow המקביל שתואר עבור OAuth 2.0:
האם OpenID Connect הוא הטוב מכל העולמות?
אם אתם מעוניינים ב Flow של authentication - אז הוא אופציה מבטיחה. קשה לי לחשוב על מקרה שבו עדיף לעשות Authentication על גבי OAuth 2.0 ולא על גבי OCID.
אם אתם מעוניינים ב Flow של authentication - אז הוא אופציה מבטיחה. קשה לי לחשוב על מקרה שבו עדיף לעשות Authentication על גבי OAuth 2.0 ולא על גבי OCID.
OIDC הוא פרוטוקול צעיר יחסית, שעדיין לא זוכה לאימוץ דומה לזה של OAuth 2.0. יש אולי עשר מימושים ויותר של OAuth 2.0 על כל מימוש OIDC.
בשנים הראשונות, מימושים של OIDC זכו לכמה "פאדיחות". במימוש של Facebook התגלה באג חמור, שזיכה את המגלה שלו ב Bug Bounty הגדול ביותר בהיסטוריה של פייסבוק. מימוש ה reference של ארגון ה OpenID עצמו סבל מכמה בעיות, וגם מוזילה נכוותה.
הזמן עבר, התקן התגבש ונוספה תוכנית ה Certification. כבר שנתיים שלא היו אירועים חריגים עם הפרוטוקול (ככל הידוע לי) ולכן אין סיבה לא להניח שאלו היו חבלי-לידה.
OpenID מסומן היום כמחליף הטבעי של SAML 2.0 (פרוטוקול אימות זהות / SSO) מסורבל ועם תיעוד לקוי - אבל שמילא את מטרתו במשך תקופה נכבדת.
אם אתם רוצים גישה למשאב (ולא זהות) - OAuth 2.0 הוא עדיין רלוונטי (אם כי אתם יכולים לתפור הרחבה תקנית על גבי OIDC ולהימנע מסכנות רבות).
בתחום המובייל (כלומר: native app) פרוטוקול ה OIDC עדיין לא נחשב טוב מספיק. שתי תקנים מרכזיים Proof Of Possession ו PKCE בפיתוח - ואמורים להעלות מדרגה בתחום.
OpenID Connect הוא לא מושלם. למשל: קיימת עדיין הדילמה של החזקת גישה למערכות רבות ע"י Identity Provider אחד. יש סכנה שפריצה למערכת הזו תאפשר גישה לתוכן רב - אך היא ככל הנראה פחותה מהסכנה שבפיזור ססמאות. מבין האופציות הקיימות, OpenID Connect היא האופציה העדיפה.
 |
| השוואה מהירה בין SAML 2.0 ל OCID |
סיכום
טוב, יכול להיות שפוסט זה הוא לא חומר הקריאה האידאלי בחופשת החג - עם הילדים. יכול להיות...
מצד שני, אם אתם הולכים לבצע תהליך Authentication בווב - כדאי שתכירו את מגוון האפשרויות הקיים והשמעות שלהן. אני לא טוען שיש לממש במערכת "מקסימום אבטחה", הכל תלוי בהקשר. כנראה שהכי נכון זה לממש "מספיק אבטחה". כמה זה "מספיק"? - רק אתם תוכלו לומר.
שיהיה בהצלחה!
קישורים רלוונטיים
ה OAuth 2.0 Threat Model המגדיר את הסיכונים השונים ביישום OAuth.
ה OAuth Grants מוסברים על ידי Alex Bilbie.
עוד קישור טוב על OAuth 2.0
"OAuth has ruined everything"
מדריך טוב ל OpenID Connect


